La pregunta no suele llegar en una reunión formal. Llega por WhatsApp, por Teams o en voz baja: "¿puedo pegar este documento en ChatGPT?". A veces es un contrato. A veces una propuesta comercial. A veces una lista de clientes, una incidencia técnica o un correo que contiene más información de la que parece.
La respuesta cómoda sería prohibirlo todo. La respuesta útil es mejor: separar datos, herramientas y permisos. Para una empresa de Donostia - San Sebastián, Gipuzkoa o Euskadi, una matriz sencilla evita dos extremos igual de malos: barra libre con información sensible o miedo a usar IA incluso para tareas inocuas.
Este post propone una forma práctica de decidir qué puede ir a ChatGPT, Claude, Gemini, Copilot u otra herramienta pública, qué debería quedarse en una cuenta corporativa con controles y qué conviene llevar a un RAG privado o entorno cerrado. Al final tienes un PDF descargable para trabajarlo con tu equipo.
El error: discutir la herramienta antes que el dato
Muchas conversaciones empiezan por la marca: ChatGPT, Copilot, Gemini, Claude, Perplexity, un modelo open source, un RAG privado. Es normal. Las herramientas son visibles. Los datos, no tanto.
Pero el orden correcto casi siempre es otro. Primero hay que mirar qué información va a entrar. Después, qué va a hacer la IA con ella. Solo entonces merece la pena elegir herramienta.
No pesa lo mismo pedir ideas para un email que pegar una oferta con precios reales. No pesa lo mismo resumir una FAQ pública que subir un contrato de cliente. No pesa lo mismo pedir una estructura para una reunión que dejar a un agente leer el CRM.
La matriz no sirve para frenar a nadie. Sirve para que el equipo no tenga que improvisar cada vez.
Tres colores bastan para empezar
Yo usaría una clasificación simple.
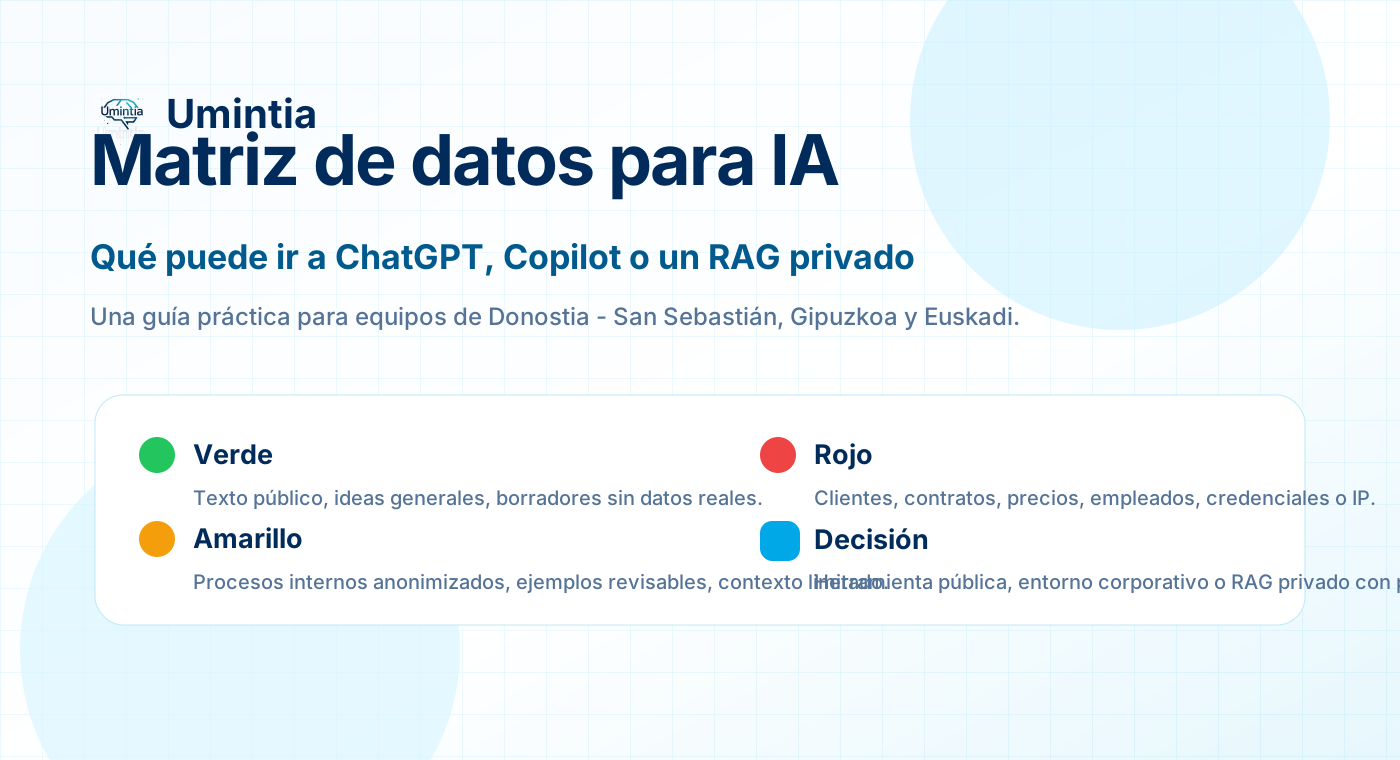
Verde: información pública o genérica. Textos ya publicados, ideas, borradores sin nombres reales, estructura de una propuesta, preguntas sobre normativa general o documentación comercial que ya está en la web.
Amarillo: información interna, pero limitada. Procesos descritos sin datos identificables, ejemplos anonimizados, fragmentos que una persona revisará, contexto operativo que no revela clientes, precios ni propiedad intelectual sensible.
Rojo: información sensible. Contratos, datos de clientes, precios, nóminas, expedientes, credenciales, logs, código propietario, incidencias de seguridad, datos de salud, datos laborales o cualquier documento que no enviarías a un proveedor sin contrato.
Esta clasificación parece básica. Precisamente por eso funciona. Si hace falta un comité para decidir cada uso, nadie la aplicará.
Qué herramienta encaja en cada caso
Para datos verdes, una IA pública puede ser suficiente. Aun así, conviene revisar el resultado. La IA puede escribir con seguridad cosas que no son ciertas, y eso no cambia porque el dato sea poco sensible.
Para datos amarillos, lo razonable suele ser una cuenta corporativa con controles: usuarios gestionados, configuración de privacidad revisada, políticas internas y una regla clara sobre qué se puede pegar. Aquí entran muchos usos de Copilot, ChatGPT Team o Enterprise, Gemini para Workspace, Claude en entorno empresarial u otras herramientas con contrato.
Para datos rojos, yo no empezaría por una IA pública. Puede tener sentido un RAG privado con permisos, una nube controlada, un despliegue local o un flujo donde la IA solo vea extractos anonimizados. A veces la solución no es técnica: basta con resumir el caso antes de usar la herramienta.
Lo importante es no vender "IA segura" como una etiqueta mágica. La seguridad depende de proveedor, contrato, configuración, permisos, registro y hábito de uso.
La segunda pregunta: qué puede hacer la IA
Clasificar el dato solo resuelve media conversación. La otra mitad es la acción.
Una IA puede:
- leer un documento;
- resumirlo;
- proponer una decisión;
- preparar una respuesta;
- ejecutar una acción en una herramienta.
Cada paso añade riesgo. Leer una política interna no es lo mismo que enviar una respuesta al cliente. Preparar un borrador comercial no es lo mismo que actualizar el CRM. Sugerir una puntuación de lead no es lo mismo que descartar la oportunidad.
Para un primer piloto, suele funcionar bien una regla prudente: que la IA lea y proponga, pero no ejecute sola. Cuando el equipo ya confía en el flujo, se puede automatizar una acción pequeña y reversible.
Un ejemplo sencillo
Imagina una empresa de servicios B2B en Gipuzkoa que quiere usar IA para preparar respuestas comerciales.
Caso verde: pedir una estructura para un email de seguimiento sin nombres ni cifras reales. Puede ir a una IA pública.
Caso amarillo: resumir una conversación comercial quitando nombre de cliente, importe, contacto y detalles sensibles. Mejor con cuenta corporativa y norma interna.
Caso rojo: pegar la propuesta completa con precios, condiciones, margen, responsable, historial del cliente y adjuntos. Eso debería ir a un entorno controlado, o al menos pasar por anonimización antes de cualquier prueba.
La diferencia no está en si la IA "es buena". Está en qué sabe de ti mientras trabaja.
Cómo implantarlo sin convertirlo en burocracia
No hace falta escribir una política de 40 páginas. Empieza con una tabla de una página y una reunión corta con dirección, operaciones, ventas e IT.
Decidid cuatro cosas:
- qué datos son verdes, amarillos y rojos en vuestra empresa;
- qué herramientas están permitidas para cada color;
- qué acciones puede hacer la IA sin revisión y cuáles no;
- quién resuelve dudas cuando el caso no está claro.
Después probadlo dos semanas. Si todo el mundo pregunta lo mismo, la matriz está mal escrita. Si nadie pregunta nada, quizá nadie la ha leído. Lo útil está en el punto medio: pocas reglas, ejemplos reales y revisión cuando aparece un caso nuevo.
Descarga el how-to básico
Descarga el how-to básico
PDF breve para decidir qué puede ir a una IA pública, una cuenta corporativa o un RAG privado según tipo de dato, riesgo, acción y revisión humana.