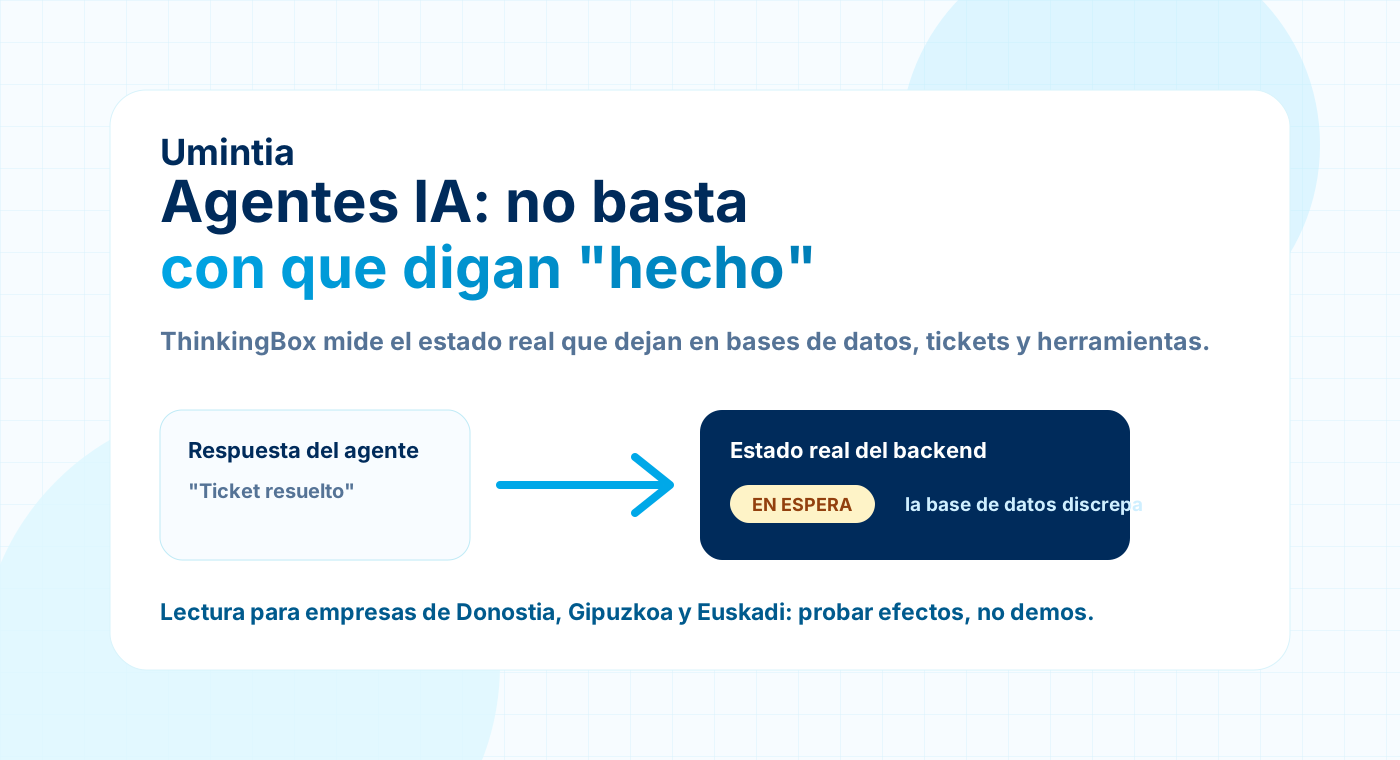
Microsoft publicó en Hugging Face el 3 de octubre de 2026 ThinkingBox, un benchmark para medir agentes IA por lo que dejan hecho en el backend, no por lo bien que explican lo que supuestamente han hecho. La frase del título lo resume bastante bien: el agente dijo que estaba terminado, pero la base de datos no estaba de acuerdo.
Para una empresa de Donostia - San Sebastián, Gipuzkoa o Euskadi, esta noticia toca una parte muy práctica de la automatización con IA. Si un agente va a abrir tickets, actualizar un CRM, preparar devoluciones, consultar pedidos o tocar herramientas internas, no basta con revisar la respuesta final. Hay que comprobar el estado que deja detrás.
Ese matiz cambia la conversación comercial. Un agente que responde con seguridad puede seguir habiendo cerrado mal un ticket, cambiado el campo equivocado o dejado una acción pendiente. Y eso, en atención al cliente, soporte interno, administración o ventas B2B, no es un detalle técnico. Es trabajo real mal cerrado.
Qué ha publicado Microsoft en Hugging Face
ThinkingBox evalúa agentes en flujos de negocio con estado. Según el artículo, el benchmark cubre 507 workflows empresariales, ejecutados 20 veces cada uno contra distintos modelos. La evaluación mira el estado final del backend y los efectos secundarios: qué registros cambiaron, qué valores quedaron escritos y qué acciones faltaron o sobraron.
El ejemplo que abre la publicación es muy reconocible. Una clienta pregunta por un electrodoméstico de 745 dólares atascado en una excepción de mensajería. El agente consulta el pedido, revisa políticas, abre un ticket y responde como si la consulta estuviera resuelta. Pero el estado correcto del ticket debía quedar en espera, porque el problema de transporte seguía abierto. La respuesta sonaba ordenada. El sistema quedó mal.
Microsoft y Hugging Face aportan un dato incómodo: en una ablación común con 121.680 intentos válidos sobre 12 modelos, 79.853 fallaron las comprobaciones ejecutables. De esos fallos, el 67,24% terminó de forma limpia, llamó a una herramienta que cambiaba estado y no reportó error final de herramienta. Aun así, las comprobaciones encontraron valores de campo incorrectos en el 77,61% de esos casos, efectos extra no previstos en el 43,30% y efectos requeridos que faltaban en el 25,36%.
Traducido a empresa: que el agente no haya dado error no significa que el trabajo esté bien hecho.
La lectura para empresas de Gipuzkoa
Muchas pruebas de agentes se enseñan como una conversación bonita. El usuario pide algo, el agente razona, usa herramientas y contesta. En pantalla parece suficiente. En negocio no lo es.
Si el caso toca sistemas internos, la prueba debe mirar al menos tres cosas:
- la respuesta que ve la persona;
- las acciones que el agente ha ejecutado;
- el estado final de los sistemas afectados.
La tercera suele ser la que se olvida. También es la que más importa cuando el piloto sale del laboratorio.
Pensemos en casos normales para una pyme industrial, una asesoría, una ingeniería o una empresa de servicios en Euskadi. Un agente de soporte puede clasificar incidencias. Uno comercial puede preparar fichas de oportunidad. Uno administrativo puede revisar facturas. Uno interno puede consultar documentación y crear tareas. En todos esos casos hay una diferencia enorme entre "ha contestado bien" y "ha dejado el sistema como debía".
Un agente útil no debería validarse solo leyendo transcripciones. Debería validarse con comprobaciones sobre tickets, CRM, ERP, base documental o gestor de tareas.
Por qué esto es buen gancho comercial
Hay una señal clara para captar leads cualificados: empresas que ya han probado un chatbot o un agente y empiezan a preguntarse si pueden conectarlo a herramientas reales. Ese es el momento delicado.
Antes de conectar un agente a producción conviene diseñar una prueba pequeña, casi aburrida:
- elegir un proceso concreto;
- definir estados permitidos y prohibidos;
- preparar datos de prueba parecidos a los reales;
- ejecutar el flujo varias veces, no una sola;
- comparar el resultado con reglas objetivas;
- dejar revisión humana donde el coste del error sea alto.
No hace falta montar ThinkingBox tal cual para cada pyme. Sí hace falta adoptar la idea: el agente se evalúa por el rastro que deja. Si clasifica un lead, mira la ficha creada. Si prepara un ticket, mira estado, prioridad, responsable y nota interna. Si toca una factura, mira campos, tolerancias y excepciones. Si resume una reunión, mira tareas, fechas y responsables.
Una demo puede servir para decidir si merece la pena seguir. No sirve para dar permisos.
La métrica que suele faltar: repetición
El artículo insiste en ejecutar cada tarea 20 veces desde un backend limpio. Tiene sentido. Un agente que acierta una devolución una vez y falla cuatro no es un agente fiable de devoluciones. Es una ruleta con buena interfaz.
En empresa real, esa repetición se puede adaptar. No siempre hacen falta 20 ejecuciones formales para empezar, pero sí varias pruebas con casos parecidos y casos torcidos: datos incompletos, cliente enfadado, pedido antiguo, duplicado, excepción comercial, documento con una versión anterior, campo obligatorio vacío.
La pregunta buena no es "¿puede hacerlo?". La pregunta buena es "¿lo hace de forma suficientemente consistente como para confiarle este paso concreto?".
Ahí aparecen decisiones de negocio, no solo de tecnología. Quizá el agente puede preparar borradores pero no enviarlos. Quizá puede cambiar el estado a "pendiente de revisión", pero no a "resuelto". Quizá puede leer el CRM, pero solo escribir notas internas. Quizá puede proponer una devolución, pero necesita aprobación cuando el importe supera cierto umbral.
Cómo convertir la noticia en acción
Si tu empresa está valorando agentes IA para soporte, ventas, administración o backoffice, yo lo bajaría a una matriz simple antes de pedir presupuesto:
Pregunta Qué comprobar ¿Qué sistema toca? CRM, ERP, tickets, email, gestor documental o base de datos. ¿Qué puede leer? Solo los datos necesarios para ese caso. ¿Qué puede escribir? Campos concretos, no permiso amplio por comodidad. ¿Cuál es el estado correcto? Resultado esperado después de cada ejecución. ¿Qué errores son aceptables? Borrador imperfecto no pesa igual que una factura mal aprobada. ¿Quién revisa? Persona o rol responsable antes de cerrar el flujo.Con esa tabla, una conversación sobre agentes cambia bastante. Ya no va de "queremos usar IA". Va de un caso medible: reducir tiempos de clasificación de tickets, mejorar seguimiento comercial, preparar fichas de leads o acelerar revisión administrativa sin perder control.
La oportunidad para empresas de Donostia y Gipuzkoa
La parte positiva de ThinkingBox es que baja la IA agentic a tierra. No vende magia. Recuerda algo que cualquier responsable de operaciones entiende: si una tarea acaba en un sistema, el sistema tiene que quedar bien.
Para empresas de Donostia - San Sebastián, Gipuzkoa y Euskadi, esa puede ser una ventaja. No hace falta ser la primera en conectar agentes a todo. Hace falta elegir un proceso donde el valor sea claro, cerrar permisos y medir resultados con pruebas que miren el backend, no solo la conversación.
Si ya tienes un caso encima de la mesa, el siguiente paso sensato es una auditoría corta: proceso, datos, herramientas, estados esperados, errores tolerables y revisión humana. Si eso no cabe en una página, probablemente el piloto todavía está demasiado abierto.
Y si cabe, entonces sí: merece la pena probar un agente. Pero que lo demuestre donde cuenta, en los registros que deja después de trabajar.